GPU und KI · Edge-Inferenz

TPU-Server auf Bare Metal.Ein Hailo-8 oder eine Coral Edge TPU, in einer Xeon-Maschine, die Ihnen allein gehört.

Ein TPU-Server bei Server Room ist ein HPE-Moonshot-Cartridge mit einem Hailo-8- oder Google-Coral-Edge-TPU-Modul im M.2-Steckplatz, monatsweise gemietet mit Root-Zugriff. Er führt int8-Vision-Modelle direkt neben Ihren Daten aus: Objekterkennung auf Kamerastreams unter Frigate oder Ihr eigener Code auf der Hersteller-Runtime. Es ist keine Google-Cloud-TPU, die nur Google vermietet, und er trainiert oder bedient keine großen Sprachmodelle.

  • Ein Mandant pro Maschine
  • M.2-Option bei m710x und m510
  • Root und Remote-Konsole
  • Eigenes Netz, AS19624

Wählen Sie das Host-Cartridge, setzen Sie das Modul im Konfigurator, und installieren Sie dann die Hersteller-Runtime auf dem gewählten System. Hailo bewertet den Hailo-8 mit bis zu 26 TOPS und hält seine Toolchain aktuell. Google bewertet die Coral mit 4 TOPS, und sie passt zu Pipelines, die bereits für die Edge TPU gebaut wurden.

Definition

Was ein TPU-Server ist und was nicht

TPU steht für Tensor Processing Unit, der Name, den Google seinen eigenen Matrix-Beschleunigern gegeben hat. Zwei sehr unterschiedliche Bauteile tragen diesen Namen. Cloud-TPUs sind große Chips zum Trainieren und Bedienen von Modellen, und Google vermietet sie nur innerhalb von Google Cloud. Die Edge TPU ist die kleine: etwa zwei Watt, nur Ganzzahlen, gebaut, um ein kompiliertes Vision-Modell neben einer Kamera oder einem Sensor-Feed auszuführen.

Wir vermieten die kleine Art und ihren engsten Rivalen, den Hailo-8, als M.2-Modul in einem dedizierten Server. Beide sind Edge-KI-Beschleuniger: Sie führen ein neuronales Netz aus, das bereits trainiert und auf int8 quantisiert wurde, und sonst nichts.

Ausgelegt für

Objekterkennung auf Videoframes, Bildklassifikation, Segmentierung und Posenschätzung. Netze aus den Familien MobileNet, EfficientDet-Lite und YOLO, quantisiert auf int8 und für das Modul kompiliert, bewerten einen Frame, ohne dass die Daten Ihre Maschine verlassen.

Nicht ausgelegt für

Training jeglicher Art. Sprachmodelle, bei jeder Quantisierung: Keines der Module kann Milliarden von Parametern halten. Float32-Modelle, die sich nicht quantisieren lassen, und Schichten, die der Hersteller-Compiler nicht unterstützt, fallen auf den Prozessor zurück oder lassen sich nicht kompilieren.

Wohin diese stattdessen gehören

Die Dimensionierung eines Sprachmodells ist Aufgabe des LLM-Hostings. Training und große Inferenz laufen auf dedizierten GPU-Servern, mit einer dedizierten GPU pro Maschine. Eine NPU und ein großer Speicherpool in einer Box sind Ryzen-AI-Server.

Die beiden M.2-Module

Hailo-8 oder Coral Edge TPU

Beide Module nehmen ein int8-Netz, das vorab vom Compiler des jeweiligen Herstellers kompiliert wurde. Sie unterscheiden sich in der angegebenen Durchsatzleistung, in den akzeptierten Frameworks und – seit Google die Coral-Software archiviert hat – darin, wer den Stack noch pflegt.

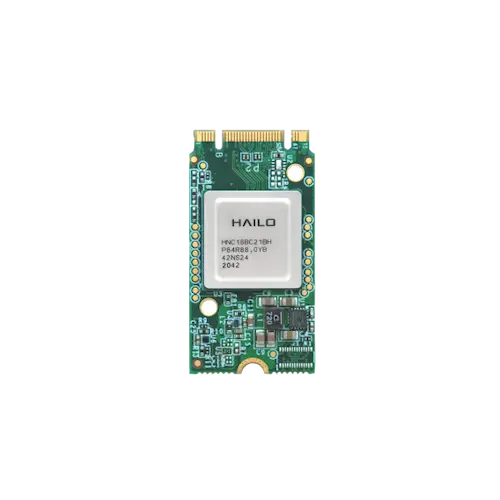
Hailo-8 M.2 KI-Beschleunigermodul, Draufsicht
Gepflegte Toolchain

Hailo-8 M.2-Modul

Angabe (von Hailo)
bis zu 26 TOPS, int8
Formfaktor
M.2 Key M, 22 × 42 mm, erweiterbar auf 2280
Schnittstelle
PCIe Gen 3
Modellquellen
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Toolchain
Dataflow Compiler, HailoRT, Model Zoo
Runtime für Hailo-8
HailoRT 4.x, hailo8-Branch (4.24.0, Juni 2026)
Optionspreis
ab $13.99/Monat

Der Dataflow Compiler quantisiert Ihr Netz und kompiliert es zu einer HEF-Datei, und HailoRT führt diese Datei aus C++ oder Python aus. Verwenden Sie den hailo8-Branch: HailoRT 5.x und der Master-Branch unterstützen nur den Hailo-10 und den Hailo-15.
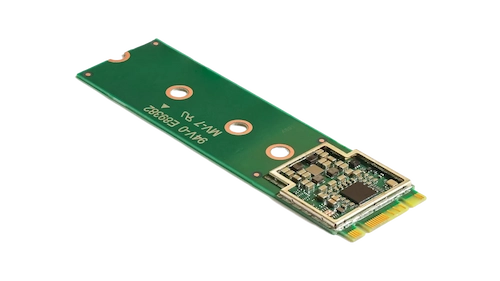
Google Coral M.2 Accelerator mit Edge TPU
Von Google archiviert

Google Coral M.2 Accelerator

Angabe (von Google)
4 TOPS, int8, bei 2 TOPS pro Watt
Prozessor
Google Edge TPU
Modellquellen
TensorFlow Lite, int8, über den Edge TPU Compiler
Runtime
libedgetpu und PyCoral, letzte PyCoral-Version 2.0.0 (Juli 2021)
Wartung
Google-Repositories archiviert; Community-Forks bauen sie heute
Optionspreis
ab $13.99/Monat

Ein Modell kompiliert entweder für die Edge TPU oder nicht, und die etablierten Vision-Modelle tun es. Google hat libedgetpu, PyCoral und die Edge-TPU-Repositories archiviert, daher sind aktuelle Kernel und Python-Versionen auf Community-Forks der Runtime und des PCIe-Treibers angewiesen. Wählen Sie sie, wenn Ihre Modelle bereits auf einer Edge TPU laufen. Für ein neues Projekt beginnen Sie mit dem Hailo-8.

Die Durchsatzangaben sind die jeweiligen Herstellerangaben. Wir veröffentlichen keinen eigenen Benchmark: Frames pro Sekunde hängen von Ihrem Modell, seiner Eingabegröße und dem Batch ab.

Datenpfad

So funktioniert das Offloading in einer Maschine

Der Xeon dekodiert weiterhin das Video, skaliert jedes Bild und führt Ihre Anwendung aus. Das Modul übernimmt nur das neuronale Netz, sodass die Kerne für die umliegende Arbeit frei bleiben. Auf dem m710x kann die Iris-Pro-P580-Grafik des Prozessors Video per Quick Sync in Hardware dekodieren, wodurch seine vier Kerne für den Rest verfügbar bleiben.

Software

Was darauf läuft, Frigate inklusive

Frigate ist der häufigste Grund, eines dieser Module in einen Server einzubauen. Es ist ein Open-Source-NVR: Es holt RTSP von Ihren Kameras, führt einen Objektdetektor auf einer niedrig aufgelösten Kopie jedes Streams aus und zeichnet die Clips auf, die der Detektor markiert hat. Frigate 0.16 bringt für jedes Modul einen Detektor mit, sodass die Frames auf der Maschine bewertet werden, die Sie mieten.

Die zwei Frigate-Detektoren

Hailo-8
Detektor hailo8l, Gerät PCIe; der Hailo-8 und der 8L teilen ihn sich
Coral
Detektor edgetpu, Gerät pci für das M.2-Modul
Modelle
YOLOv9, YOLOv6n und SSD MobileNet auf dem Hailo-8; auf dem Coral muss YOLOv9 von Hand konvertiert werden
Frigates Zeiten
etwa 10 ms pro Frame für SSD MobileNet v1 und etwa 18 ms für YOLOv9-tiny bei 320 × 320, gemessen auf dem Hailo-8L; rund 10 ms für den Coral

Die Hailo-Unterstützung erreichte das Frigate-Repository in 0.16. Frigates eigene Hardware-Seite empfiehlt den Coral für eine Neuinstallation nicht mehr. Starten Sie ein neues Projekt auf dem Hailo-8 und behalten Sie den Coral für Modelle, die bereits für die Edge TPU kompiliert sind.

Die Kameras dimensionieren

Die Erkennung läuft nicht auf jedem Frame. Frigate bewertet pro Kamera einige Frames pro Sekunde auf dem Erkennungsstream und kopiert die Aufnahme ohne Neukodierung. Ein Modul, das einen Frame in 10 ms bewertet, schafft daher in der Größenordnung von hundert Erkennungen pro Sekunde, aufgeteilt auf Ihre Kameras.

Der Host ist meist früher am Ende als das Modul. Der Xeon dekodiert und skaliert jeden Stream, daher bestimmen seine Kerne und sein Hardware-Dekoder die Kameraanzahl ebenso wie das Modul. Die Aufnahmen landen auf den eigenen Platten des Cartridges, und die Platten, der Speicher und die Portgeschwindigkeit sind Zeilen im selben Konfigurator.

Ihre Kameras müssen die Maschine trotzdem erreichen. Frigate zieht RTSP über das Netzwerk, und jede Maschine wird mit einem unlimitierten Port ausgeliefert, sodass die eingehenden Streams nicht abgerechnet werden; die Verbindung vom Standort der Kameras und der Tunnel, über den sie läuft, sind von Ihnen einzurichten.

Die Inferenzzeiten sind Frigates veröffentlichte Werte für seine eigenen Modelle, kein Benchmark von uns. Wir installieren das Betriebssystem und geben Ihnen Root: Frigate, den PCIe-Treiber und die Laufzeitumgebung installieren und pinnen Sie selbst.

Live aus dem Bestellkatalog

Zwei Host-Cartridges, bepreist wie an der Kasse

Das Modul ist eine Optionszeile auf zwei HPE-Moonshot-Cartridges: dem m710x mit einem Quad-Core-Xeon E3 und dem m510 mit einem 8- oder 16-Kern-Xeon D. Jeder Preis unten ist die Einstiegskonfiguration dieser Linie, mit dem Modul als einer Zeile obendrauf.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maschine, Einstiegskonfiguration
$62.58/Monat
+ Google Coral Edge TPU
$13.99/Monat
+ Hailo-8
$13.99/Monat
Einrichtung, einmalig
$29
Städte
New York, Bucharest, San Francisco, Amsterdam, Miami

Abrechnung in Euro in Bucharest, Amsterdam, zu denselben Beträgen.

m710x konfigurieren

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Maschine, Einstiegskonfiguration
$62.58/Monat
+ Google Coral Edge TPU
$13.99/Monat
+ Hailo-8
$13.99/Monat
Einrichtung, einmalig
$29
Städte
New York, Miami, Bucharest, Amsterdam, San Francisco

Abrechnung in Euro in Bucharest, Amsterdam, zu denselben Beträgen.

m510 konfigurieren

Ein Modul verändert die Maschine, daher ist die Bestellung eine Sonderanfertigung und trägt die angezeigte einmalige Einrichtungsgebühr. Speicher, Platten, Portgeschwindigkeit und Abrechnungszeitraum werden alle im selben Konfigurator festgelegt, der die endgültige Monatssumme vor dem Bezahlen anzeigt.

Einrichtung

Von der Bestellung zur ersten Inferenz

Wir installieren das Betriebssystem und geben Ihnen Root. Die Laufzeitumgebung des Herstellers ist nicht vorinstalliert, daher bestimmen und pinnen Sie deren Version selbst.

  1. Host konfigurieren. Öffnen Sie den m710x- oder m510-Konfigurator, wählen Sie den Hailo-8 oder den Coral und das Betriebssystem.
  2. Prüfen, ob das Modul am Bus ist. Führen Sie lspci -nn | grep -Ei '1e60|1ac1' aus. Der Hailo-8 erscheint als 1e60:2864 und der Coral als 1ac1:089a.
  3. Hailo-8: Installieren Sie den PCIe-Treiber und HailoRT aus der 4.x-Linie (der hailo8-Zweig von hailo-ai/hailort oder die Pakete aus Hailos Developer Zone) und führen Sie dann hailortcli fw-control identify aus, um Firmware und Seriennummer des Moduls auszulesen.
  4. Coral: Bauen Sie den Gasket- und Apex-PCIe-Treiber sowie libedgetpu aus einem gepflegten Fork, laden Sie den Treiber und prüfen Sie, ob /dev/apex_0 existiert, bevor Sie Ihr erstes Modell ausführen.
  5. Versionen pinnen. Halten Sie Kernel, Treiber und Laufzeitumgebung auf Versionen, die zusammen funktionieren. Auf unserer Seite aktualisiert nichts die Maschine hinter Ihrem Rücken.

Antworten

Fragen zum TPU-Server

Was ist ein TPU-Server?

Ein Server mit einer angeschlossenen Tensor Processing Unit. Bei Server Room ist das ein dediziertes HPE-Moonshot-Cartridge mit einer Google Coral Edge TPU oder einem Hailo-8 im M.2-Slot, für int8-Inferenz auf Vision-Modellen. Googles Cloud-TPUs sind ein anderer und viel größerer Chip, der nur innerhalb von Google Cloud gemietet werden kann.

Kann ich eine Google Cloud TPU bei Ihnen mieten?

Nein. Cloud-TPUs gibt es nur in Google Cloud, und kein Hosting-Anbieter kann eine einbauen. Für Training oder das Bereitstellen großer Modelle auf Hardware, die Sie kontrollieren, sehen Sie sich unsere GPU-Dedicated-Server an, bei denen jede Maschine eine dedizierte GPU hat.

Wie viel kostet ein TPU-Server?

Eine komplette Maschine mit einem Hailo-8 oder einem Coral beginnt bei $76.57 im Monat. Das Modul ist eine Zeile obendrauf auf der Maschine, ab $13.99 im Monat für den Hailo-8 und ab $13.99 für den Coral, und die Bestellung trägt eine einmalige Einrichtungsgebühr ab $29. Die Host-Karten oben zeigen, zu welcher Maschine jeder Preis gehört.

Hailo-8 oder Coral Edge TPU: Was soll ich wählen?

Hailo bewertet den Hailo-8 mit bis zu 26 TOPS und Google den Coral mit 4 TOPS, beide auf int8. Der Hailo-8 hat außerdem gepflegte Software: HailoRT 4.24.0 dafür erschien im Juni 2026, während Google die Coral-Repositories archiviert hat. Wählen Sie den Coral, wenn Ihre Modelle bereits auf einer Edge TPU laufen.

Kann ich Frigate NVR auf einem TPU-Server betreiben?

Ja. Frigate 0.16 hat für beide Module einen Detektor: den hailo8l-Detektor mit dem Gerät auf PCIe für den Hailo-8 und den edgetpu-Detektor mit dem Gerät auf pci für den Coral M.2. Frigate bewertet pro Kamera einige Frames pro Sekunde, sodass ein Modul mehrere Streams bedient. Wir installieren das Betriebssystem und geben Ihnen Root; Frigate, den PCIe-Treiber und die Laufzeitumgebung installieren und pinnen Sie selbst.

Kann ein TPU-Server ein LLM ausführen?

Nein. Keines der Module kann ein Modell mit Milliarden von Parametern halten, bei keiner Quantisierung. Dimensionieren Sie das Modell auf unserer LLM-Hosting-Seite und führen Sie es dann auf einem GPU-Dedicated-Server oder auf einer unserer Ryzen-AI-Maschinen aus.

Welche Betriebssysteme und Treiber funktionieren?

Jedes System, das der Konfigurator für das Cartridge anbietet, kann installiert werden. HailoRT ist für Linux und Windows gebaut; die Coral-Laufzeitumgebung und ihre Community-Forks zielen auf Linux. Wir installieren das System, und Sie installieren die Laufzeitumgebung in der von Ihnen gewählten Version.

Wo stehen Ihre TPU-Server?

TPU-Server werden in diesen Städten verkauft: New York, Bucharest, San Francisco, Amsterdam, Miami. Sie laufen in unserem eigenen Netz, AS19624. Bestellungen in diesen Städten werden in Euro abgerechnet, zu denselben Beträgen: Bucharest, Amsterdam.

Wird die TPU mit anderen Kunden geteilt?

Nein. Das Modul sitzt in Ihrem Cartridge und die Maschine hat einen Mieter. Sie erhalten Root und die Remote-Konsole, und keine Arbeitslast eines anderen Kunden läuft darauf.

Wählen Sie ein Cartridge, aktivieren Sie das Modul

Fragen vor der Bestellung? Unsere Chat-KI antwortet in Sekunden und kann Ihr Konto und Ihre Server prüfen, und eine Person übernimmt, wann immer Sie es wünschen.

m710x konfigurieren