GPU et IA · Inférence en périphérie

Serveur TPU sur bare metal.Un Hailo-8 ou un Coral Edge TPU, dans une machine Xeon qui n'appartient qu'à vous.

Un serveur TPU chez Server Room est une cartouche HPE Moonshot équipée d'un module Hailo-8 ou Google Coral Edge TPU sur son emplacement M.2, louée au mois avec accès root. Il exécute des modèles de vision int8 à côté de vos données : détection d'objets sur des flux caméra sous Frigate, ou votre propre code sur le runtime du fabricant. Ce n'est pas un Cloud TPU de Google, que seul Google loue, et il n'entraîne ni ne sert de grands modèles de langage.

  • Un seul locataire par machine
  • Option M.2 sur m710x et m510
  • Root et console distante
  • Réseau propre, AS19624

Choisissez la cartouche hôte, cochez le module dans le configurateur, puis installez le runtime du fabricant sur le système que vous avez retenu. Hailo évalue le Hailo-8 jusqu'à 26 TOPS et maintient sa chaîne d'outils à jour. Google évalue le Coral à 4 TOPS, et il convient aux pipelines déjà construits pour l'Edge TPU.

Définition

Ce qu'est un serveur TPU, et ce qu'il n'est pas

TPU signifie tensor processing unit, le nom que Google a donné à ses propres accélérateurs matriciels. Deux éléments très différents portent ce nom. Les Cloud TPU sont de grandes puces pour l'entraînement et le service de modèles, et Google ne les loue qu'au sein de Google Cloud. L'Edge TPU est le petit : environ deux watts, entiers uniquement, conçu pour exécuter un modèle de vision compilé à côté d'une caméra ou d'un flux de capteurs.

Nous louons le petit modèle et son rival le plus proche, le Hailo-8, sous forme de module M.2 dans un serveur dédié. Tous deux sont des accélérateurs d'IA en périphérie : ils exécutent un réseau de neurones déjà entraîné et quantifié en int8, et rien d'autre.

Dimensionné pour

La détection d'objets sur des images vidéo, la classification d'images, la segmentation et l'estimation de pose. Les réseaux des familles MobileNet, EfficientDet-Lite et YOLO, quantifiés en int8 et compilés pour le module, traitent une image sans que les données quittent votre machine.

Non dimensionné pour

L'entraînement, sous quelque forme que ce soit. Les modèles de langage, à n'importe quelle quantification : aucun des deux modules ne peut contenir des milliards de paramètres. Les modèles Float32 qui ne se quantifient pas, et les couches que le compilateur du fabricant ne prend pas en charge, qui retombent sur le processeur ou échouent à la compilation.

Où ceux-là vont à la place

Dimensionner un modèle de langage est le travail de l'hébergement LLM. L'entraînement et l'inférence à grande échelle s'exécutent sur des serveurs dédiés GPU, avec un GPU dédié par machine. Un NPU et un grand pool de mémoire dans une seule boîte, ce sont les serveurs Ryzen AI.

Les deux modules M.2

Hailo-8 ou Coral Edge TPU

Les deux modules prennent un réseau int8 compilé à l'avance par le compilateur du fabricant. Ils diffèrent par le débit nominal, par les frameworks qu'ils acceptent et, depuis que Google a archivé le logiciel Coral, par qui maintient encore la pile.

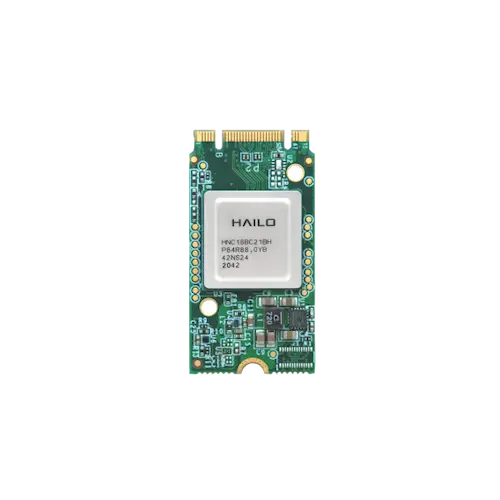
Module d'accélération IA Hailo-8 M.2, vue de dessus
Chaîne d'outils maintenue

Module Hailo-8 M.2

Évaluation (selon Hailo)
jusqu'à 26 TOPS, int8
Format
M.2 Key M, 22 × 42 mm, extensible à 2280
Interface
PCIe Gen 3
Sources de modèles
TensorFlow, TensorFlow Lite, ONNX, Keras, PyTorch
Chaîne d'outils
Dataflow Compiler, HailoRT, Model Zoo
Runtime pour Hailo-8
HailoRT 4.x, branche hailo8 (4.24.0, juin 2026)
Prix de l'option
à partir de $13.99/mois

Le Dataflow Compiler quantifie votre réseau et le compile en fichier HEF, et HailoRT exécute ce fichier depuis C++ ou Python. Utilisez la branche hailo8 : HailoRT 5.x et la branche master ne prennent en charge que les Hailo-10 et Hailo-15.
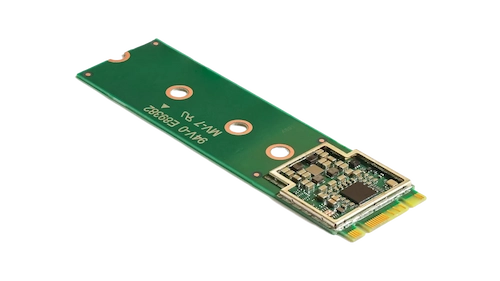
Accélérateur Google Coral M.2 avec Edge TPU
Archivé par Google

Accélérateur Google Coral M.2

Évaluation (selon Google)
4 TOPS, int8, à 2 TOPS par watt
Processeur
Google Edge TPU
Sources de modèles
TensorFlow Lite, int8, via l'Edge TPU Compiler
Runtime
libedgetpu et PyCoral, dernière version PyCoral 2.0.0 (juillet 2021)
Maintenance
Dépôts Google archivés ; des forks communautaires le compilent aujourd'hui
Prix de l'option
à partir de $13.99/mois

Un modèle se compile pour l'Edge TPU ou non, et les modèles de vision établis le font. Google a archivé libedgetpu, PyCoral et les dépôts Edge TPU, de sorte que les noyaux actuels et les versions de Python reposent sur des forks communautaires du runtime et du pilote PCIe. Choisissez-le lorsque vos modèles tournent déjà sur un Edge TPU. Pour un nouveau projet, commencez sur le Hailo-8.

Les chiffres de débit sont l'évaluation propre de chaque fabricant. Nous ne publions aucun benchmark de notre part : les images par seconde dépendent de votre modèle, de sa taille d'entrée et du lot.

Chemin des données

Comment fonctionne l’exécution déportée au sein d’une seule machine

Le Xeon décode toujours la vidéo, redimensionne chaque image et exécute votre application. Le module ne prend en charge que le réseau de neurones, rien d’autre, afin que les cœurs restent libres pour le travail qui l’entoure. Sur le m710x, les graphismes Iris Pro P580 du processeur peuvent décoder la vidéo matériellement avec Quick Sync, ce qui laisse ses quatre cœurs pour le reste.

Logiciels

Ce qui tourne dessus, y compris Frigate

Frigate est la raison la plus courante d’installer l’un de ces modules dans un serveur. C’est un NVR open source : il récupère le flux RTSP de vos caméras, exécute un détecteur d’objets sur une copie basse résolution de chaque flux et enregistre les séquences que le détecteur a marquées. Frigate 0.16 embarque un détecteur pour chaque module, de sorte que les images sont évaluées sur la machine que vous louez.

Les deux détecteurs Frigate

Hailo-8
détecteur hailo8l, périphérique PCIe ; le Hailo-8 et le 8L le partagent
Coral
détecteur edgetpu, périphérique pci pour le module M.2
Modèles
YOLOv9, YOLOv6n et SSD MobileNet sur le Hailo-8 ; sur le Coral, YOLOv9 doit être converti à la main
Temps de Frigate
environ 10 ms par image pour SSD MobileNet v1 et environ 18 ms pour YOLOv9-tiny en 320 × 320, mesurés sur le Hailo-8L ; autour de 10 ms pour le Coral

La prise en charge de Hailo est arrivée dans le dépôt Frigate en 0.16. La page matérielle de Frigate ne recommande plus le Coral pour une nouvelle installation. Démarrez un nouveau projet sur le Hailo-8 et gardez le Coral pour les modèles déjà compilés pour l’Edge TPU.

Dimensionner les caméras

La détection ne s’exécute pas sur chaque image. Frigate évalue quelques images par seconde et par caméra sur le flux de détection, et copie l’enregistrement sans le réencoder. Un module qui évalue une image en 10 ms peut donc traiter de l’ordre d’une centaine de détections par seconde, réparties entre vos caméras.

L’hôte tend à s’épuiser avant le module. Le Xeon décode et redimensionne chaque flux, donc ses cœurs et son décodeur matériel déterminent le nombre de caméras autant que le module. Les enregistrements atterrissent sur les disques propres de la cartouche, et les disques, la mémoire et la vitesse du port sont des lignes du même configurateur.

Vos caméras doivent tout de même atteindre la machine. Frigate récupère le RTSP sur le réseau, et chaque machine est livrée avec un port non mesuré, de sorte que les flux entrants ne sont pas facturés ; la liaison depuis le site où se trouvent les caméras, et le tunnel sur lequel elle passe, sont à votre charge.

Les temps d’inférence sont les chiffres publiés par Frigate pour ses propres modèles, pas un benchmark de notre part. Nous installons le système d’exploitation et vous donnons root : Frigate, le pilote PCIe et le runtime sont à installer et à épingler par vos soins.

En direct du catalogue de commande

Deux cartouches hôtes, au prix affiché par le tunnel de commande

Le module est une ligne d’option sur deux cartouches HPE Moonshot : la m710x avec un Xeon E3 quadricœur, et la m510 avec un Xeon D à 8 ou 16 cœurs. Chaque prix ci-dessous correspond à la configuration d’entrée de cette ligne, avec le module comme ligne supplémentaire.

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Machine, configuration d’entrée
$62.58/mois
+ Google Coral Edge TPU
$13.99/mois
+ Hailo-8
$13.99/mois
Installation, une fois
$29
Villes
New York, Bucharest, San Francisco, Amsterdam, Miami

Facturé en euros à Bucharest, Amsterdam, aux mêmes montants.

Configurer la m710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

Machine, configuration d’entrée
$62.58/mois
+ Google Coral Edge TPU
$13.99/mois
+ Hailo-8
$13.99/mois
Installation, une fois
$29
Villes
New York, Miami, Bucharest, Amsterdam, San Francisco

Facturé en euros à Bucharest, Amsterdam, aux mêmes montants.

Configurer la m510

Un module modifie la machine, donc la commande est une configuration personnalisée et comporte les frais d’installation uniques indiqués. La mémoire, les disques, la vitesse du port et la durée de facturation se règlent tous dans le même configurateur, qui affiche le total mensuel final avant que vous ne payiez.

Mise en place

De la commande à la première inférence

Nous installons le système d’exploitation et vous donnons root. Le runtime du fournisseur n’est pas préinstallé, donc sa version est à choisir et à épingler par vos soins.

  1. Configurez l’hôte. Ouvrez le configurateur m710x ou m510, cochez le Hailo-8 ou le Coral, et choisissez le système d’exploitation.
  2. Vérifiez que le module est sur le bus. Exécutez lspci -nn | grep -Ei '1e60|1ac1'. Le Hailo-8 apparaît comme 1e60:2864 et le Coral comme 1ac1:089a.
  3. Hailo-8 : installez le pilote PCIe et HailoRT de la branche 4.x (la branche hailo8 de hailo-ai/hailort, ou les paquets de la Developer Zone de Hailo), puis exécutez hailortcli fw-control identify pour lire le firmware et le numéro de série du module.
  4. Coral : compilez le pilote PCIe gasket et apex ainsi que libedgetpu depuis un fork maintenu, chargez le pilote, et vérifiez que /dev/apex_0 existe avant d’exécuter votre premier modèle.
  5. Épinglez les versions. Maintenez le noyau, le pilote et le runtime à des versions qui fonctionnent ensemble. Rien de notre côté ne met à jour la machine dans votre dos.

Réponses

Questions sur les serveurs TPU

Qu’est-ce qu’un serveur TPU ?

Un serveur auquel est attachée une unité de traitement tensoriel. Chez Server Room, il s’agit d’une cartouche HPE Moonshot dédiée avec un Google Coral Edge TPU ou un Hailo-8 sur son emplacement M.2, pour l’inférence int8 sur des modèles de vision. Les Cloud TPU de Google sont une puce différente et bien plus grande, louée uniquement dans Google Cloud.

Puis-je louer un Google Cloud TPU chez vous ?

Non. Les Cloud TPU ne sont disponibles que dans Google Cloud, et aucun hébergeur ne peut en installer un. Pour entraîner ou servir de grands modèles sur du matériel que vous contrôlez, consultez nos serveurs dédiés GPU, où chaque machine possède un GPU dédié.

Combien coûte un serveur TPU ?

Une machine complète avec un Hailo-8 ou un Coral démarre à $76.57 par mois. Le module est une ligne en plus de la machine, à partir de $13.99 par mois pour le Hailo-8 et de $13.99 pour le Coral, et la commande comporte des frais d’installation uniques à partir de $29. Les cartes hôtes ci-dessus indiquent à quelle machine correspond chaque prix.

Hailo-8 ou Coral Edge TPU : lequel choisir ?

Hailo évalue le Hailo-8 jusqu’à 26 TOPS et Google évalue le Coral à 4 TOPS, tous deux en int8. Le Hailo-8 dispose aussi de logiciels maintenus : HailoRT 4.24.0 pour lui est sorti en juin 2026, tandis que Google a archivé les dépôts Coral. Choisissez le Coral lorsque vos modèles tournent déjà sur un Edge TPU.

Puis-je exécuter Frigate NVR sur un serveur TPU ?

Oui. Frigate 0.16 possède un détecteur pour les deux modules : le détecteur hailo8l avec le périphérique réglé sur PCIe pour le Hailo-8, et le détecteur edgetpu avec le périphérique réglé sur pci pour le Coral M.2. Frigate évalue quelques images par seconde et par caméra, donc un seul module dessert plusieurs flux. Nous installons le système d’exploitation et vous donnons root ; Frigate, le pilote PCIe et le runtime sont à installer et à épingler par vos soins.

Un serveur TPU peut-il exécuter un LLM ?

Non. Aucun des deux modules ne peut contenir un modèle avec des milliards de paramètres, quelle que soit la quantification. Dimensionnez le modèle sur notre page d’hébergement LLM, puis exécutez-le sur un serveur dédié GPU ou sur l’une de nos machines Ryzen AI.

Quels systèmes d’exploitation et pilotes fonctionnent ?

Tout système proposé par le configurateur pour la cartouche peut être installé. HailoRT est conçu pour Linux et Windows ; le runtime Coral et ses forks communautaires ciblent Linux. Nous installons le système, et vous installez le runtime dans la version de votre choix.

Où se trouvent vos serveurs TPU ?

Les serveurs TPU sont vendus dans ces villes : New York, Bucharest, San Francisco, Amsterdam, Miami. Ils fonctionnent sur notre propre réseau, AS19624. Les commandes dans ces villes sont facturées en euros, aux mêmes montants : Bucharest, Amsterdam.

Le TPU est-il partagé avec d’autres clients ?

Non. Le module se trouve à l’intérieur de votre cartouche et la machine n’a qu’un seul locataire. Vous disposez de root et de la console distante, et aucune charge de travail d’un autre client ne s’y exécute.

Choisissez une cartouche, cochez le module

Des questions avant de commander ? Notre IA de chat répond en quelques secondes et peut vérifier votre compte et vos serveurs, et une personne prend le relais dès que vous le demandez.

Configurer une m710x