GPU 与 AI · 边缘推理

裸金属上的 TPU 服务器。在只属于你的 Xeon 机器中,搭载 Hailo-8 或 Coral Edge TPU。

Server Room 的 TPU 服务器是一台 HPE Moonshot 卡匣,其 M.2 插槽上装有 Hailo-8 或 Google Coral Edge TPU 模块,按月租用并带 root 权限。它在你的数据旁运行 int8 视觉模型:在 Frigate 下对摄像头流进行目标检测,或在厂商运行时上运行你自己的代码。它不是 Google Cloud TPU——那种只有 Google 才出租,也不用于训练或运行大语言模型。

  • 每台机器一位租户
  • m710x 和 m510 上的 M.2 选件
  • Root 与远程控制台
  • 自有网络,AS19624

选择主机卡匣,在配置器中勾选模块,然后在你选定的系统上安装厂商运行时。Hailo 将 Hailo-8 标定为最高 26 TOPS,并持续维护其工具链。Google 将 Coral 标定为 4 TOPS,适合已经为 Edge TPU 构建的流水线。

定义

什么是 TPU 服务器,什么不是

TPU 是张量处理单元的缩写,是 Google 为其自有矩阵加速器所起的名称。两种截然不同的部件共用此名。Cloud TPU 是用于训练和运行模型的大型芯片,Google 仅在 Google Cloud 内部出租。Edge TPU 则是小型的那种:约两瓦、仅整数运算,专为在摄像头或传感器数据流旁运行已编译的视觉模型而生。

我们出租的是小型的那种及其最接近的竞品 Hailo-8,作为专用服务器内的 M.2 模块。两者都是边缘 AI 加速器:它们运行已经训练并量化到 int8 的神经网络,除此之外别无他用。

适用场景

视频帧上的目标检测、图像分类、分割和姿态估计。来自 MobileNet、EfficientDet-Lite 和 YOLO 系列的模型,量化到 int8 并为模块编译后,无需数据离开你的机器即可完成一帧的推理。

不适用场景

任何形式的训练。任何量化程度下的语言模型:两种模块都无法容纳数十亿参数。无法量化的 Float32 模型,以及厂商编译器不支持的层,会回退到处理器或编译失败。

这些需求应转向何处

语言模型的规模规划是 LLM 托管 的职责。训练和大规模推理在 GPU 专用服务器 上运行,每台机器配备一块专用 GPU。一个盒子中同时拥有 NPU 和大内存池的是 Ryzen AI 服务器。

两种 M.2 模块

Hailo-8 或 Coral Edge TPU

两种模块都运行由厂商自有编译器预先编译的 int8 网络。它们在标定吞吐量、接受的框架上有所不同,而且由于 Google 已将 Coral 软件归档,在谁仍在维护技术栈方面也存在差异。

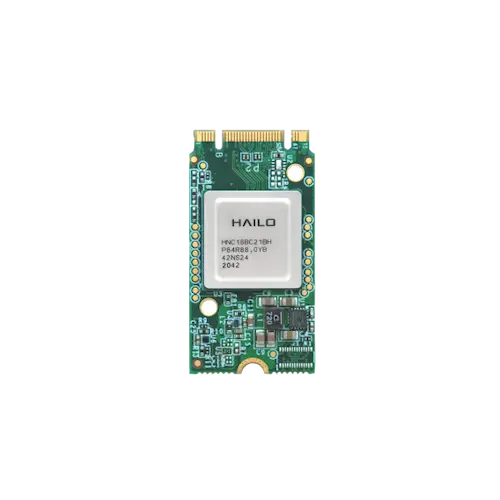
Hailo-8 M.2 AI 加速模块,俯视图
工具链持续维护

Hailo-8 M.2 模块

标定(Hailo 官方)
最高 26 TOPS,int8
外形规格
M.2 Key M,22 × 42 mm,可扩展至 2280
接口
PCIe Gen 3
模型来源
TensorFlow、TensorFlow Lite、ONNX、Keras、PyTorch
工具链
Dataflow Compiler、HailoRT、Model Zoo
Hailo-8 运行时
HailoRT 4.x,hailo8 分支(4.24.0,2026 年 6 月)
选件价格
从 $13.99/月

Dataflow Compiler 将你的网络量化并编译为 HEF 文件,HailoRT 从 C++ 或 Python 运行该文件。请使用 hailo8 分支:HailoRT 5.x 和 master 分支仅支持 Hailo-10 和 Hailo-15。
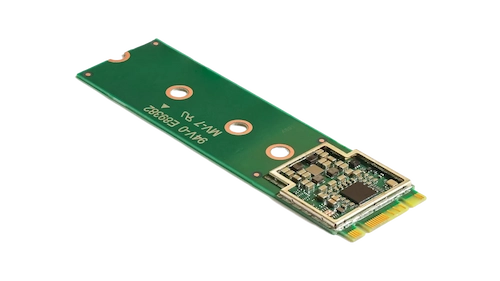
带 Edge TPU 的 Google Coral M.2 加速器
已被 Google 归档

Google Coral M.2 加速器

标定(Google 官方)
4 TOPS,int8,每瓦 2 TOPS
处理器
Google Edge TPU
模型来源
TensorFlow Lite,int8,通过 Edge TPU Compiler
运行时
libedgetpu 和 PyCoral,最后一个 PyCoral 版本为 2.0.0(2021 年 7 月)
维护状态
Google 仓库已归档;如今由社区分支继续构建
选件价格
从 $13.99/月

模型要么能为 Edge TPU 编译,要么不能,而成熟的视觉模型都能。Google 已归档 libedgetpu、PyCoral 和 Edge TPU 仓库,因此当前内核和 Python 版本依赖运行时及 PCIe 驱动的社区分支。当你的模型已在 Edge TPU 上运行时选择它。对于新项目,请从 Hailo-8 开始。

吞吐量数据为各厂商自行标定。我们不发布自己的基准测试:每秒帧数取决于你的模型、输入尺寸和批次大小。

数据路径

一台机器内部卸载的工作原理

Xeon 仍然负责解码视频、调整每一帧的大小并运行您的应用程序。模块只承担神经网络,因此核心可以腾出来处理周围的工作。在 m710x 上,处理器的 Iris Pro P580 显卡可以通过 Quick Sync 在硬件中解码视频,从而让四个核心处理其余任务。

软件

上面运行什么,包括 Frigate

Frigate 是在服务器中安装这些模块的常见原因。它是一个开源 NVR:从您的摄像头拉取 RTSP 流,在每个流的低分辨率副本上运行目标检测器,并记录检测器标记的片段。Frigate 0.16 为每个模块都配备了检测器,因此帧会在您租用的机器上进行评分。

两个 Frigate 检测器

Hailo-8
检测器 hailo8l,设备 PCIe;Hailo-8 和 8L 共用
Coral
检测器 edgetpu,设备 pci 用于 M.2 模块
模型
Hailo-8 上为 YOLOv9、YOLOv6n 和 SSD MobileNet;在 Coral 上,YOLOv9 需要手动转换
Frigate 的耗时
在 Hailo-8L 上测得,SSD MobileNet v1 每帧约 10 毫秒,YOLOv9-tiny 在 320 × 320 下约 18 毫秒;Coral 约 10 毫秒

Hailo 支持在 0.16 版本进入 Frigate 仓库。Frigate 自己的硬件页面不再推荐 Coral 用于新安装。在 Hailo-8 上启动新项目,将 Coral 留给已经为 Edge TPU 编译好的模型。

摄像头规模估算

检测不会在每一帧上运行。Frigate 在检测流上对每个摄像头每秒评分几帧,并在不重新编码的情况下复制录像。因此,一个每帧评分 10 毫秒的模块足以支持每秒约一百次检测,由您的摄像头分摊。

主机往往比模块先耗尽。Xeon 解码并调整每个流的大小,因此其核心和硬件解码器对摄像头数量的限制与模块一样大。录像存储在卡匣自带的磁盘上,而磁盘、内存和端口速度都在同一个配置器中设置。

您的摄像头仍然需要连接到机器。Frigate 通过网络拉取 RTSP,每台机器都配备一个不限流量端口,因此入站流不会计费;从摄像头所在站点到机器的链路以及其运行的隧道由您自行安排。

推理时间是 Frigate 为其自有模型发布的数字,不是我们的基准测试。我们安装操作系统并将 root 权限交给您:Frigate、PCIe 驱动程序和运行时由您安装并锁定版本。

来自订单目录的实时信息

两款主机卡匣,按结账价格标价

该模块是两款 HPE Moonshot 卡匣上的可选配置项:配备四核 Xeon E3 的 m710x,以及配备 8 核或 16 核 Xeon D 的 m510。以下每个价格都是该系列的入门配置,模块作为其上的一个加项。

HPE ProLiant m710x

Intel Xeon E3-1585L v5

Intel Xeon E3-1585L v5 Quad Core 3.00 Ghz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

机器,入门配置
$62.58/月
+ Google Coral Edge TPU
$13.99/月
+ Hailo-8
$13.99/月
设置费,一次性
$29
城市
New York, Bucharest, San Francisco, Amsterdam, Miami

在 Bucharest, Amsterdam 以欧元计费,金额相同。

配置 m710x

HPE ProLiant m510

Intel Xeon D-1548 / Intel Xeon D-1587

Intel Xeon D-1548 Octa Core 2.00 GHz · 32 GB DDR4 · 1 × NVMe-SSD 240 GB · 1 Gbps

机器,入门配置
$62.58/月
+ Google Coral Edge TPU
$13.99/月
+ Hailo-8
$13.99/月
设置费,一次性
$29
城市
New York, Miami, Bucharest, Amsterdam, San Francisco

在 Bucharest, Amsterdam 以欧元计费,金额相同。

配置 m510

模块会改变机器配置,因此订单属于定制构建,并收取所示的一次性设置费。内存、磁盘、端口速度和计费周期都在同一个配置器中设置,付款前会显示最终每月总额。

设置过程

从下单到首次推理

我们安装操作系统并将 root 权限交给您。供应商运行时未预装,因此版本由您选择并锁定。

  1. 配置主机。 打开 m710x 或 m510 配置器,勾选 Hailo-8 或 Coral,并选择操作系统。
  2. 检查模块是否在总线上。 运行 lspci -nn | grep -Ei '1e60|1ac1'。Hailo-8 显示为 1e60:2864,Coral 显示为 1ac1:089a。
  3. Hailo-8: 从 4.x 系列安装 PCIe 驱动程序和 HailoRT(hailo-ai/hailort 的 hailo8 分支,或 Hailo 开发者专区的软件包),然后运行 hailortcli fw-control identify 读取模块的固件和序列号。
  4. Coral: 从维护中的分支构建 gasket 和 apex PCIe 驱动程序以及 libedgetpu,加载驱动程序,并在运行第一个模型之前检查 /dev/apex_0 是否存在。
  5. 锁定版本。 将内核、驱动程序和运行时保持在相互兼容的版本上。我们这边不会有任何操作在您不知情的情况下更新机器。

解答

TPU 服务器问题

什么是 TPU 服务器?

一台连接了张量处理单元的服务器。在 Server Room,这是一台专用 HPE Moonshot 卡匣,其 M.2 插槽上装有 Google Coral Edge TPU 或 Hailo-8,用于视觉模型的 int8 推理。Google 的 Cloud TPU 是一种不同且大得多的芯片,只能在 Google Cloud 内部租用。

我可以从你们这里租用 Google Cloud TPU 吗?

不可以。Cloud TPU 仅在 Google Cloud 中提供,任何托管公司都无法上架。对于在您控制的硬件上训练或提供大型模型,请查看我们的 GPU 专用服务器,每台机器都配有专用 GPU。

TPU 服务器多少钱?

配备 Hailo-8 或 Coral 的整机每月起价 $76.57。模块是机器之上的一个加项,Hailo-8 每月从 $13.99 起,Coral 从 $13.99 起,订单还需支付一次性设置费,从 $29 起。上面的主机卡显示了每个价格对应的机器。

Hailo-8 还是 Coral Edge TPU:我应该选择哪个?

Hailo 将 Hailo-8 标定为最高 26 TOPS,Google 将 Coral 标定为 4 TOPS,均为 int8。Hailo-8 还有持续维护的软件:其 HailoRT 4.24.0 于 2026 年 6 月发布,而 Google 已归档 Coral 仓库。当您的模型已经在 Edge TPU 上运行时,选择 Coral。

我可以在 TPU 服务器上运行 Frigate NVR 吗?

可以。Frigate 0.16 为两个模块都提供了检测器:Hailo-8 使用 hailo8l 检测器并将设备设为 PCIe,Coral M.2 使用 edgetpu 检测器并将设备设为 pci。Frigate 对每个摄像头每秒评分几帧,因此一个模块可以服务多个流。我们安装操作系统并将 root 权限交给您;Frigate、PCIe 驱动程序和运行时由您安装并锁定版本。

TPU 服务器可以运行 LLM 吗?

不可以。无论采用何种量化方式,这两个模块都无法容纳具有数十亿参数的模型。请在我们的 LLM 托管页面上估算模型规模,然后在 GPU 专用服务器或我们的 Ryzen AI 机器上运行。

哪些操作系统和驱动程序可用?

配置器为卡匣提供的任何系统都可以安装。HailoRT 面向 Linux 和 Windows 构建;Coral 运行时及其社区分支面向 Linux。我们安装系统,您安装所选版本的运行时。

你们的 TPU 服务器位于哪里?

TPU 服务器在这些城市出售:New York, Bucharest, San Francisco, Amsterdam, Miami。它们运行在我们自己的网络 AS19624 上。这些城市的订单以欧元计费,金额相同:Bucharest, Amsterdam。

TPU 与其他客户共享吗?

不共享。模块位于您的卡匣内部,机器只有一个租户。您获得 root 权限和远程控制台,其他客户的工作负载不会在其上运行。

选择卡匣,勾选模块

下单前有问题?我们的聊天 AI 几秒内即可回答,并能查看您的账户和服务器,随时可转接人工客服。

配置 m710x